※学習初学者の勉強のアウトプットですので、もしコードや解釈に間違い等あればご指摘頂けますと幸いです。
メモも兼ねて、各コードなるべく詳しく説明をつけるようにしています。
ハイパーパラメーターの調整について
機械学習においてハイパーパラメーターの調整はとても重要ですが、ハイパーパラメーターの種類はたくさんあり、これを手動で毎回変更するのは大変です。
ハイパーパラメーターの範囲を指定して、精度の良いハイパーパラメーターを自動で見つけてもらう方法があります。主な方法としては、グリッドサーチとランダムサーチの2種類があります。
グリッドサーチ:
調整したいハイパーパラメーターの値の候補を明示的に複数指定し、ハイパーパラメーターセットを作成します。モデルの評価を繰り返すことにより、最適なハイパーパラメーターセットが作成されます。値の候補を明示的に指定するため、ハイパーパラメーターの値に文字列や整数、True/Falseといった数学的に連続ではない値をとるハイパーパラメータの探索に向いている一方、多数のハイパーパラメーターをチューニングするのは不向きです。
ランダムサーチ:
ランダムサーチは、ハイパーパラメーターが取りうる値の範囲を指定し、確率で決定されたハイパーパラメーターセットを用いてモデルの評価を行うことを繰り返し、最適なパラメーターを探す手法です。値の範囲は、ハイパーパラメーターの確率関数を指定します。
パラメータの数が多い場合やモデルの学習に時間がかかる場合には、ランダムサーチの方が効率的。
ランダムサーチ
scikit-learn内の乳がんのデータセットを使用し、ランダムサーチにてハイパーパラメーターの調整を行ってみます。
モデルは決定木で実行してみます。
#必要なライブラリのインポート
import scipy.stats
from sklearn.datasets import load_breast_cancer
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

#乳がんのデータセットを取得し、中身を確認する
cancer = load_breast_cancer()

#X,yにそれぞれ説明変数と目的変数を格納する
X = cancer.data

#yにtargetを格納する
y = cancer.target

#train_data ,testデータに分割する
train_X, test_X, train_y, test_y = train_test_split(X, y, test_size = 0.3, random_state=42)

#ハイパーパラメータの値の候補を設定する
model_param_set_grid = {DecisionTreeClassifier(): {
                                "criterion": ["gini", "entropy"],
                                "max_depth": [None, 10, 20, 30, 40],
                                "min_samples_split": [2, 5, 10],
                                "min_samples_leaf": [1, 2, 4],
                                "random_state":[42]}}

max_score = 0
best_param = None

#ランダムサーチでハイパーパラメーターを検索する
for model, param in model_param_set_grid.items():
    clf =RandomizedSearchCV(model, param)
    clf.fit(train_X, train_y)
    pred_y = clf.predict(test_X)
    score = accuracy_score(test_y, pred_y)
    if max_score < score:
        max_score = score
        best_param = clf.best_params_

print(f"ハイパーパラメーター:{best_param}")
print(f"ベストスコア:{max_score}")
dtc = DecisionTreeClassifier()
dtc.fit(train_X, train_y)
print()
print('調整なし')
print(dtc.score(test_X, test_y))
解説
#必要なライブラリのインポート
import scipy.stats
from sklearn.datasets import load_breast_cancer
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

#乳がんのデータセットを取得し、中身を確認する
cancer = load_breast_cancer()

#X,yにそれぞれ説明変数と目的変数を格納する
X = cancer.data

#yにtargetを格納する
y = cancer.target

#train_data ,testデータに分割する
train_X, test_X, train_y, test_y = train_test_split(X, y, test_size = 0.3, random_state=42)
まず必要なライブラリをインポートし、X,yにそれぞれ説明変数、目的変数を格納し、訓練データとテストデータに分けます。
#ハイパーパラメータの値の候補を設定する
model_param_set_grid = {DecisionTreeClassifier(): {
                                "criterion": ["gini", "entropy"],
                                "max_depth": [None, 10, 20, 30, 40],
                                "min_samples_split": [2, 5, 10],
                                "min_samples_leaf": [1, 2, 4],
                                "random_state":[42]}}

max_score = 0
best_param = None
今回は決定木でパラメーター最適化を行ってみます。
まず、"ctiterion"では決定木モデルの分割基準を指定します。一般的に、分割基準としてジニ不純度やエントロピーが使われます。
gini: ジニ不純度は、ノード内のサンプルが異なるクラスに属する確率の重み付き合計。ジニ不純度が低いほど、ノードの純度が高くなる。
entropy: エントロピーは、ノード内のサンプルのクラス分布の不確実性を測定します。エントロピーが低いほど、ノードの純度が高くなります。
max_depth: 決定木の最大の深さを指定します。デフォルトはNone,適切な深さを指定することで過学習を防ぐことができます。
min_sample_split:ノードを分割するために必要な最小サンプル数。
min_samples_leaf:葉ノードに必要な最小サンプル数を指定します。葉ノードがこの値よりも少ないサンプル数を持つ場合、そのノードは分割されません。
"random_state"を設定することにより、再現性を確保できます。任意の整数値を指定します。
#ランダムサーチでハイパーパラメーターを検索する
for model, param in model_param_set_grid.items():
    clf =RandomizedSearchCV(model, param)
    clf.fit(train_X, train_y)
    pred_y = clf.predict(test_X)
    score = accuracy_score(test_y, pred_y)
    if max_score < score:
        max_score = score
        best_param = clf.best_params_
model_param_set_gridにはモデル名とそのハイパーパラメータの候補が設定されていますが、.items()でモデル名をmodelに、パラメーターの候補をparamに格納します。それらをRandomizedSearchCVに入れランダムサーチを実行し、最適なハイパーパラメーターを探索していきます。各モデルに対してランダムサーチを行った後、テストデータを使用して予測を行いスコアを出し、最も精度の高いモデルとパラメーターの組み合わせをbest_paramに格納します。
print(f"ハイパーパラメーター:{best_param}")
print(f"ベストスコア:{max_score}")
dtc = DecisionTreeClassifier()
dtc.fit(train_X, train_y)
print()
print('調整なし')
print(dtc.score(test_X, test_y))
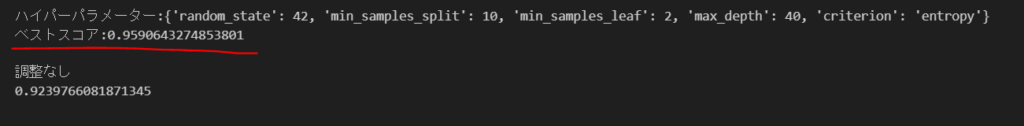
ランダムサーチで探索した最適値と、その最適値を用いたモデルのスコアを表示してみます。
また、ハイパーパラメーターを何も調整しなかった場合のスコアも出してみます。
ランダムサーチで探索したハイパーパラメーターを使用した方が、スコアが高いことがわかります。