説明変数7つのデータを使用して重回帰モデルであるラッソ回帰分析を行ってみます。
※習初学者の勉強のアウトプットですので、もしコードや解釈に間違い等あればご指摘頂けますと幸いです。
ラッソ回帰とは
ラッソ回帰は線形重回帰分析にL1正則化を用いた分析手法です。
L1正則化とは、目的関数にパラメータの絶対値の和を加えた正則化のことであり、他のデータとあまりにも離れた一部のデータの重みを0にし、不要なパラメータを削ります。
データの行数に比べて列数が多い場合には、ラッソ回帰を利用するとよいです。
ラッソ回帰の実装
#必要なモジュールをインポートする
import urllib.request
import zipfile
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import Lasso
%matplotlib inline
import matplotlib.pyplot as plt
import numpy as np

#既にデータ(sample_data)をダウンロード済の前提
# データの読み込み
sample_data = pd.read_excel("./sample_Data.xls")

#読み込んだデータをテストデータ、検証データに分ける
train_X, test_X, train_y, test_y = train_test_split(
    sample_data.drop("Y",axis=1),
    sample_data["Y"], random_state=42)

# ラッソ回帰で回帰分析を行う
model = Lasso() #ラッソ回帰の呼び出し
model_fit = model.fit(train_X, train_y)    #ラッソ回帰の当てはめ
score_lasso = model.score(test_X, test_y)  #決定係数算出
y_predict = model.predict(test_X)  # テストデータを使って予測を行う

#決定係数を表示
print(f"Lasso R2: {score_lasso}")

#偏回帰係数を算出
coef = model.coef_
df_coef = pd.DataFrame(coef).T
df_coef.columns = sample_data.columns[:-1]
df_coef.index = ["Estimated coefficients"]
df_coef = df_coef.round(2)
df_coef

#切片を算出
intercept = model.intercept_
intercept

#偏回帰係数をグラフで描画してみる
plt.bar(df_coef.columns, coef)
plt.xlabel("X")
plt.ylabel("Estimated coefficiance")
解説
# データの読み込み
sample_data = pd.read_excel("./sample_Data.xls")ダウンロードして保存したExcelファイルをpd.read_excel("ファイル名")で読み込みます。
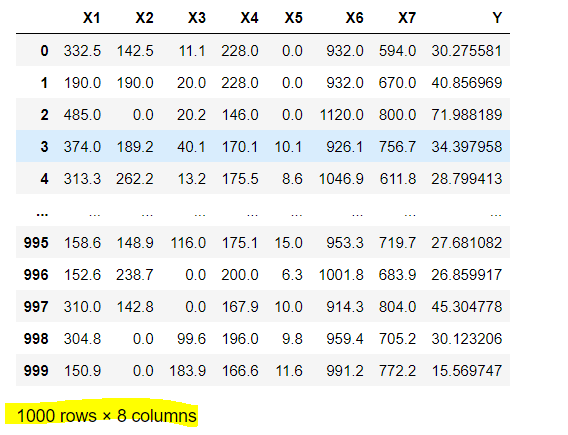
読み込んだファイルは以下です。sample_dataで表示させることができます。
今回は1000行×8列(説明変数7+目的変数1)のデータを準備しています。
#読み込んだデータをテストデータ、検証データに分ける
train_X, test_X, train_y, test_y = train_test_split(
    sample_data.drop("Y",axis=1),
sample_data["Y"], random_state=42)読み込んだデータをtrain_test_splitでテストデータ、訓練データに分けます。test_size, train_sizeを記載して分割割合を指定することができるが、今回は記載なし=デフォルト値で分析を行っている。デフォルト値は、訓練データ:0.75、/テストデータ:0.25の割合。
train_test_splitの引数であるrandom_stateのデフォルト値はNoneが入っており、Noneのままだとデータのランダムな行が固定されません。
つまり、train_test_splitを再実行すると再実行前と異なるtrainデータ、testデータが返されるため、予測結果が都度変わってしまいますので、random_stateにint型の任意の値を設定して行順番を固定します。
random_stateの値は任意だが、プログラミングで使用される乱数シードは「42」がよく用いられています。
全世界で1600万部売れた「銀河ヒッチハイク・ガイド」という書籍の中でこの「42」という数字が出てくるようで、ここからきている模様。
上記の例だと、以下のように分割される。Xには説明変数、yには目的変数を入れます。今回はY列を求めたいので、これをyに入れます。
・train_X
sample_data.drop("Y",axis=1)、つまりsample_dataから一番右の"Y'列をドロップし、かつ1000行*0.75=750行が格納される
・test_X
train_Xの残りの250行が格納される
・train_y
sample_data["Y"]、つまりsample_dataの'Y'列、かつ1000行*0.75=750行が格納される
・test_y
train_yの残りの250行が格納される
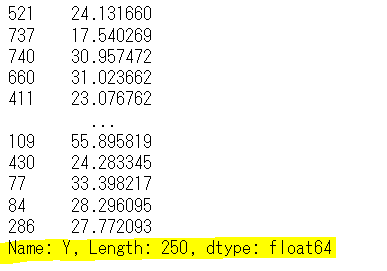
train_Xで中身を確認してみると、sample_dataの一番右の'Y'列がドロップされ、750行が格納されているのが確認できます。

test_yも念のため中身を確認してみると、'Y"列の250行が格納されているのが確認できます。
# 線形回帰で回帰分析を行う
model = Lasso() #ラッソ回帰の呼び出し
model_fit = model.fit(train_X, train_y)    #ラッソ回帰の当てはめ
score_lasso = model.score(test_X, test_y)  #決定係数算出
y_predict = model.predict(test_X) # テストデータを使って予測を行うLasso()で線形回帰モデルを呼び出し、model.fit(訓練データX, 訓練データy)で線形回帰モデルを当てはめてみます。
model.score(テストデータX, テストデータ_y)で決定係数を算出します。
model.predict(テストデータ_X)で、モデルを使用して、Xに対するyの予測値を算出します。
#決定係数を表示
print(f"Lasso R2: {score_lasso}")
決定係数を表示させてみます。
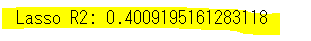
決定係数とは、推定された回帰式の当てはまりの良さを表します。0-1の間で表現され、1に近いほど当てはまりがいい=説明変数が目的変数をよく説明している、ということになります。
様々なページを見ると、決定係数が0.5以上だと当てはまりがよいと説明しているものが多いが、絶対的な基準はない模様。
決定係数の平方根=相関係数という関係があるので、例えば0.5の平方根は相関係数0.7となり、強い相関関係があると言えそうです。決定係数0.5はこのような観点から一つの目安となりそう。
今回の0.4009...の平方根を取ってみると、相関係数0.63となるので、かなり相関関係があると言えます。
#偏回帰係数を算出
coef = model.coef_   #偏回帰係数を算出
df_coef = pd.DataFrame(coef).T  #データフレームに変換し転置して説明変数を列にもってくる
df_coef.columns = sample_data.columns[:-1]  #サンプルデータの特徴量名称をデータフレームの列名に割当
df_coef.index = ["Estimated coefficients"] #行にEstimated coeffientsラベルを割当
df_coef = df_coef.round(2) #係数を小数点以下2桁にラウンド
df_coef
偏回帰係数を算出すると、以下のような結果になります。
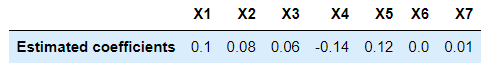
そもそも偏回帰係数がなんぞやと言うと、「重回帰分析における変数の係数」と定義されています。
ある一つの変数以外を固定し、その一つの変数を1単位増加/減少した際に、目的変数がどれだけ増加/減少するかを意味します。
#切片を算出
intercept = model.intercept_
intercept
切片を算出すると以下のようになる。
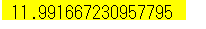
つまり、この重回帰式は以下のように記述できます。
y = (0.1)x1 + (0.08)x2 + (0.06)x3 + (-0.14)x4 + (0.12)x5 + (0.0)x6 + (0.01)x7 + 11.9916...
#偏回帰係数をグラフで描画してみる
plt.bar(df_coef.columns, coef)
plt.xlabel("X")
plt.ylabel("Estimated coefficiance")
偏回帰係数がどのくらい影響するか、可視化してみます。
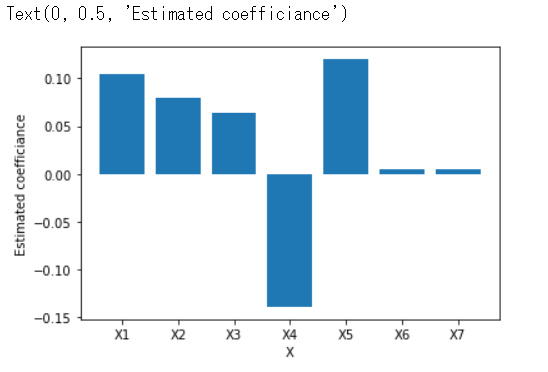
この中だと、X4,X5の影響度が大きいことがわかります。X5の値が大きいとyの値は大きく予測され、一方X4の値が大きいとyの値が小さく予測されます。